Data Product realizzato nell’ambito dell’evento “Ecomic: Hack the Data Culture”.
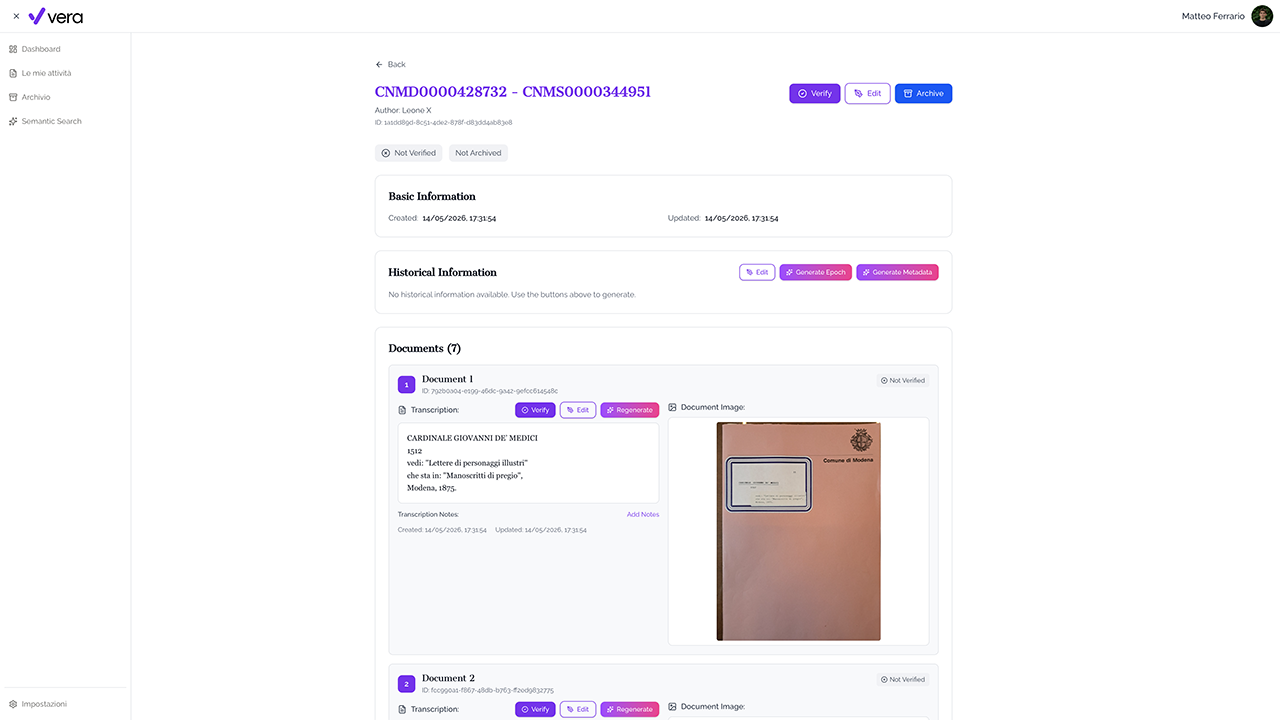
Il data product “VERA” propone una piattaforma digitale per la gestione, descrizione e valorizzazione di manoscritti storici. La soluzione integra immagini delle pagine, trascrizioni, metadati descrittivi e strumenti di ricerca, revisione e archiviazione.
Il progetto è stato sviluppato dal team “Malevi”, composto da Matteo Ferrario, Vittorio Napoli e Leonardo Mussato, nell’ambito dell’hackathon “Ecomic: Hack the Data Culture”, svoltosi dal 9 all’11 dicembre 2025 presso il Museo Nazionale Romano – Palazzo Massimo.
La soluzione si è classificata al 1° posto nella Sfida n.1 – “AI per la descrizione del patrimonio culturale”, dedicata allo sviluppo di strumenti intelligenti per automatizzare e migliorare la descrizione dei beni culturali.
La piattaforma comprende l’applicazione web VERA, destinata a operatori e revisori, e un servizio API che gestisce dati, file e modelli AI. L’operatore può creare un manoscritto, aggiungere pagine singolarmente o importarle tramite archivi ZIP contenenti file XML/TEI, immagini ed eventuali trascrizioni.
La soluzione supporta archivi, biblioteche, ricercatori e catalogatori nella gestione dei manoscritti digitalizzati, combinando automazione e controllo umano. Le trascrizioni e i metadati proposti dall’AI possono essere verificati, modificati e confermati prima dell’archiviazione.
Il Data Product utilizza modelli collegati tramite Ollama per trascrivere le pagine ed estrarre informazioni fisiche, codicologiche e storico-descrittive, tra cui materiale, rigatura, legatura, annotazioni, conservazione, epoca, stile e provenienza. L’architettura integra PostgreSQL, Amazon S3, Weaviate, Redis, FusionAuth e Swagger.
Use case principali: analisi linguistica, addestramento di modelli NLP, ricerca archivistica, storica e filologica, digital humanities e percorsi narrativi digitali.
Target: ricercatori, università, sviluppatori AI, enti culturali.